Questa volta la prova è stata un po’ diversa dal solito. Il Mac Studio M5 Ultra non è un computer che si può giudicare soltanto aprendo qualche applicazione, esportando un video e guardando due benchmark. È una macchina estrema, soprattutto nella configurazione che abbiamo provato noi, e per capirla davvero bisogna ragionare su memoria, intelligenza artificiale locale, consumi e possibili alternative.
La recensione nasce dal lavoro fatto insieme a Francesco, IT manager di andreagaleazzi.com e offerte.club, che lo ha messo alla prova anche come macchina da sviluppo e per l’esecuzione locale di modelli AI. Abbiamo quindi cercato di rispondere a una domanda molto semplice: questo Mac Studio è soltanto un esercizio di potenza oppure può diventare uno strumento di lavoro concreto?
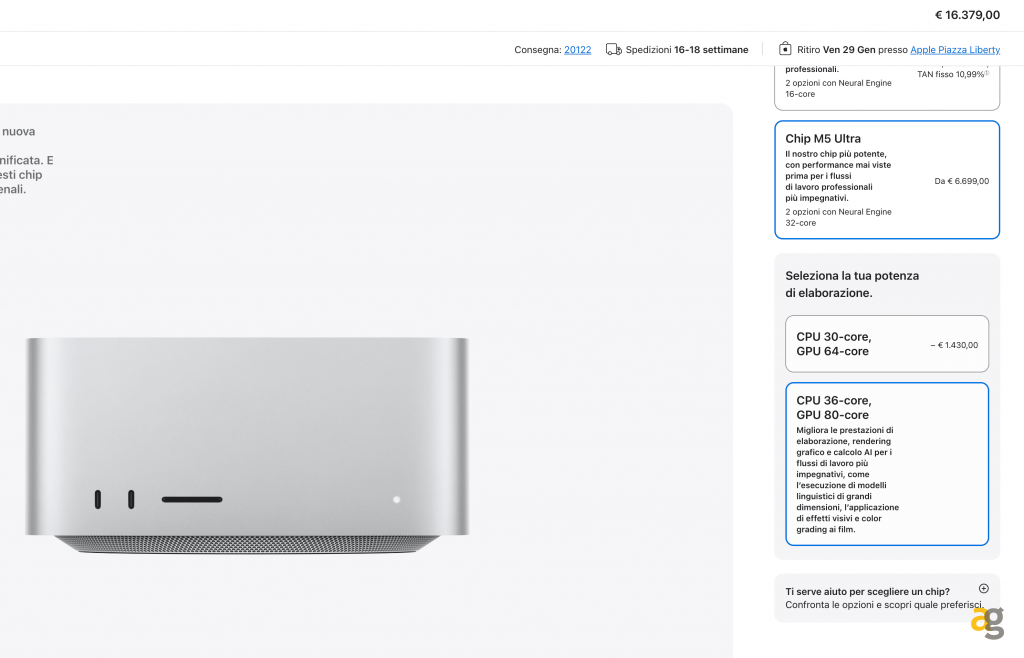
La configurazione in prova è quella con M5 Ultra, 256 GB di memoria unificata e SSD da 8 TB, al prezzo di 16.379€. Costa tantissimo, inutile girarci attorno. Ma una parte importante della nostra analisi consiste proprio nel separare le prestazioni del chip dal costo degli upgrade di memoria e archiviazione.
Prezzo e configurazioni
Partiamo dal capitolo più delicato. Il Mac Studio con M5 Ultra parte indicativamente da circa 6.000-7.000 euro, in base alla configurazione scelta. Rispetto al precedente M3 Ultra, a parità di dotazione, l’aumento si colloca all’incirca tra 1.000 e 1.500 euro.
È un rincaro importante e si sente, anche perché arriva in un periodo in cui chip e memorie costano sempre di più. Detto questo, non siamo davanti allo stesso computer con un processore appena aggiornato: l’incremento di prestazioni è notevole soprattuto nei carichi di intelligenza artificiale. Quei mille euro in più non diventano improvvisamente pochi, ma almeno sono accompagnati da un salto concreto.
La macchina provata da noi sale molto più in alto perché i 256 GB di memoria e soprattutto gli 8 TB di SSD incidono in maniera pesantissima sul listino. È una configurazione che ha senso soltanto quando memoria e spazio di archiviazione servono davvero. Per la maggior parte dei professionisti la base rimane molto più equilibrata.
Il consiglio è di non acquistare memoria “per sicurezza”. Prima bisogna capire quali modelli si vogliono eseguire, quanto contesto serve e quali altre applicazioni dovranno rimanere aperte. Solo dopo si può decidere se 96 GB siano sufficienti oppure se abbia davvero senso passare a 256 GB.
Qui trovate il link alla pagina Apple con tutti i prezzi per le varie configurazioni: LINK PAGINA PREZZI MAC STUDIO
Il confronto con una workstation RTX 5090
Quando si parla di AI locale, il confronto più immediato è con un PC dotato di NVIDIA RTX 5090, una soluzione consumer ma top di gamma. La scheda parte teoricamente da circa 2.000 euro, ma tra disponibilità, prezzi reali e tutti gli altri componenti necessari una workstation completa può arrivare facilmente intorno ai 5.000 euro o superarli.
La 5090 è potentissima e in molti carichi ha una capacità di calcolo superiore. Il limite, però, è nei suoi 32 GB di VRAM. Il Mac Studio base mette invece a disposizione circa 96 GB di memoria unificata, che possono essere utilizzati anche dalla GPU. Non significa che 96 GB di memoria Apple siano identici a 96 GB di VRAM dedicata, ma significa che sul Mac si possono caricare modelli che su una singola 5090 semplicemente non entrano.
Per superare quel limite sul PC bisogna passare a più schede video. A quel punto servono una scheda madre adeguata, un alimentatore enorme, un sistema di raffreddamento importante e software capaci di distribuire bene il lavoro. Costi, consumi, rumore e complessità salgono in fretta.
Il Mac Studio offre prestazioni GPU inferiori in alcuni scenari, ma arriva già assemblato, è compatto, silenzioso e pronto da usare, dunque non vince necessariamente sulla forza bruta, vince sull’equilibrio generale e sulla quantità di memoria disponibile in una scatola piccolissima.
🔍 Clicca sull’immagine per vederla a piena risoluzione
Consumi e silenziosità
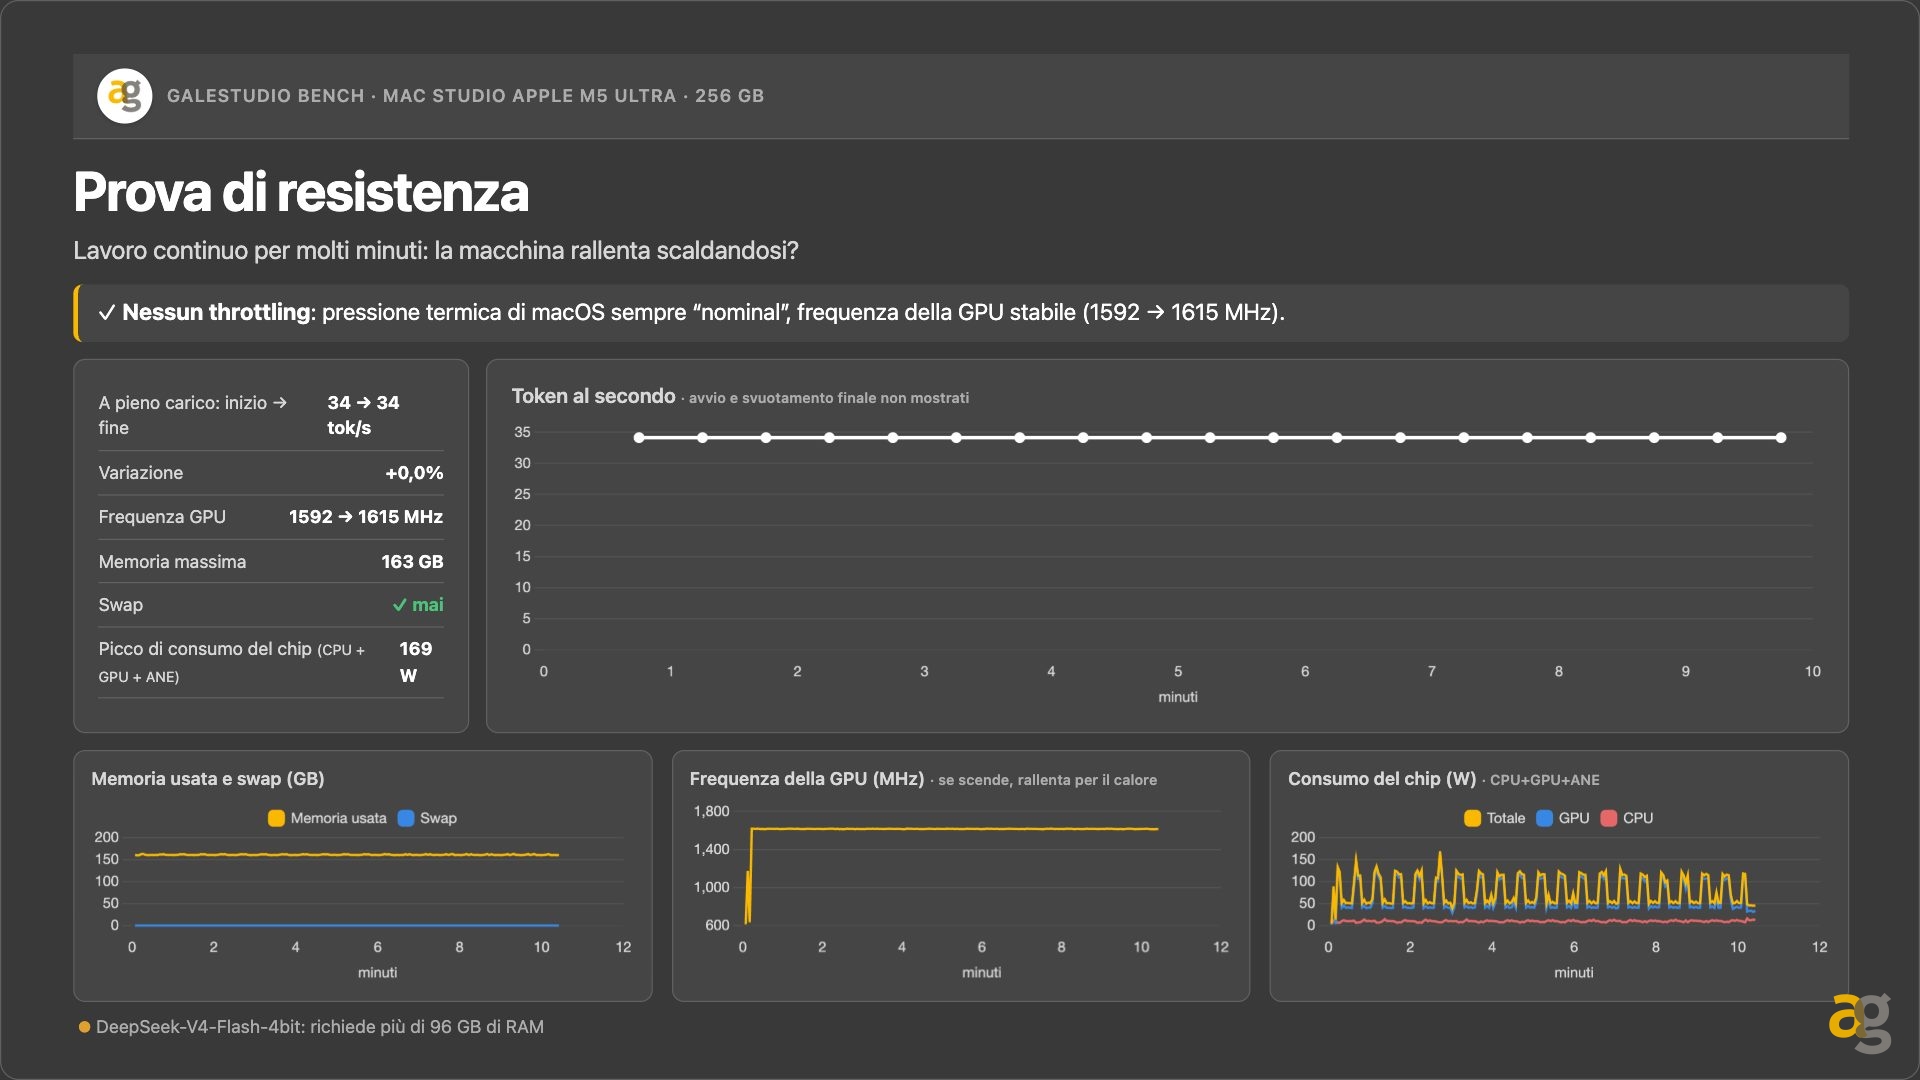
Sotto carico intenso abbiamo misurato circa 170 watt di picco. Nell’utilizzo quotidiano, tra sviluppo, navigazione e applicazioni normali, si rimane invece nell’ordine dei 10-20 watt.
Sono numeri impressionanti se rapportati alla potenza e alla memoria disponibili. Una workstation con RTX 5090 consuma molto di più e deve inevitabilmente smaltire più calore. Il Mac Studio, invece, rimane quasi sempre silenziosissimo, anche quando lo si mette davvero al lavoro.
Una macchina del genere può rimanere accesa tutto il giorno sulla scrivania senza trasformare lo studio in una sala server. E nei momenti in cui non viene utilizzata per l’AI torna a essere un normale computer da lavoro, molto efficiente e con consumi bassissimi.
🔍 Clicca sull’immagine per vederla a piena risoluzione
Tra 5-6 anni una RTX 5090 non sarà più una scheda adatta ai giochi AAA del momento. Il Mac Studio non nasce certamente per quello, ma con ogni probabilità continuerà a essere un eccellente computer per programmazione, produttività e uso da ufficio. Non è una garanzia matematica, ma la longevità dei Mac e il supporto software Apple giocano a suo favore.
Memoria unificata: il vero motivo per guardare questo Mac
Il punto centrale non è soltanto quanta memoria ci sia, ma come venga utilizzata. Nei PC tradizionali la RAM di sistema e la memoria della scheda video sono separate: la CPU lavora sulla prima, la GPU sulla seconda.
Su Apple Silicon la memoria è unificata e condivisa. CPU e GPU lavorano sullo stesso bacino, senza dover duplicare continuamente i dati tra due memorie diverse. Dal punto di vista degli LLM locali questo è fondamentale, perché permette alla GPU di accedere a quantità di memoria molto superiori ai 24 o 32 GB tipici delle schede video consumer.
Va usato il termine corretto: non sono 96 o 256 GB di VRAM dedicata. È memoria condivisa e una parte rimane necessaria a macOS e alle applicazioni. Il vantaggio pratico, però, resta enorme: si possono caricare modelli molto più grandi senza costruire una workstation multi-GPU.
È qui che il Mac Studio è diventato quasi per caso una macchina estremamente interessante per l’intelligenza artificiale. In origine Apple lo comunicava soprattutto come strumento per montaggio video, grafica, rendering e produzione creativa. Poi i modelli locali hanno iniziato a richiedere quantità enormi di memoria e quella caratteristica, già presente nell’architettura Apple Silicon, si è trasformata in uno dei suoi punti di forza principali.
Attenzione: il modello non è l’unica cosa che occupa memoria
Questo è uno degli aspetti più facili da sottovalutare. Se un modello pesa 90 GB, un Mac con 96 GB non è automaticamente sufficiente. Oltre ai pesi del modello bisogna lasciare spazio al sistema operativo, alle applicazioni, al contesto e alla KV cache, la memoria che conserva le informazioni necessarie durante l’elaborazione.
Su una macchina da 96 GB è quindi molto più sensato utilizzare un modello che ne occupa 40 o 50, lasciando margine al resto. Arrivare a saturare quasi tutta la memoria significa limitare il contesto, chiudere applicazioni oppure rischiare un crollo delle prestazioni.
Durante i benchmark sul vecchio Mac Studio M2 Max da 32 GB abbiamo dovuto chiudere Chrome. Da solo occupava circa 2,5 GB e, in quella situazione, erano 2,5 GB che servivano davvero. È un esempio banale, ma rende bene l’idea: ogni singolo gigabyte di memoria in più è utile.
Il contesto diventa ancora più importante nella programmazione. Se chiediamo all’AI di analizzare un intero progetto, leggere molti file o modificare una parte di codice tenendo conto di tutto il resto, ogni informazione inserita nella conversazione occupa memoria. Lo stesso vale per i token utilizzati dal modello per ragionare prima di produrre la risposta.
Francesco ha qui fatto dei test sul modello Qwen2.5, che normalmente usa sul suo Mac Studio M2 Max, e poi li hab ripetuti su M5 Ultra:
| Mac Studio M2 Max | Mac Studio M5 Ultra | |
| CPU / GPU | 12 / 30 core | 36 / 80 core |
| Memoria | 32 GB | 256 GB |
| Modello | Qwen2.5-Coder-7B-Instruct 4-bit | Qwen2.5-Coder-7B-Instruct 4-bit |
| Runtime | oMLX | oMLX |
| Generazione (TG) | 67,8 tok/s | 163,2 tok/s |
| Prefill (PP) | 566 tok/s | 5.645 tok/s |
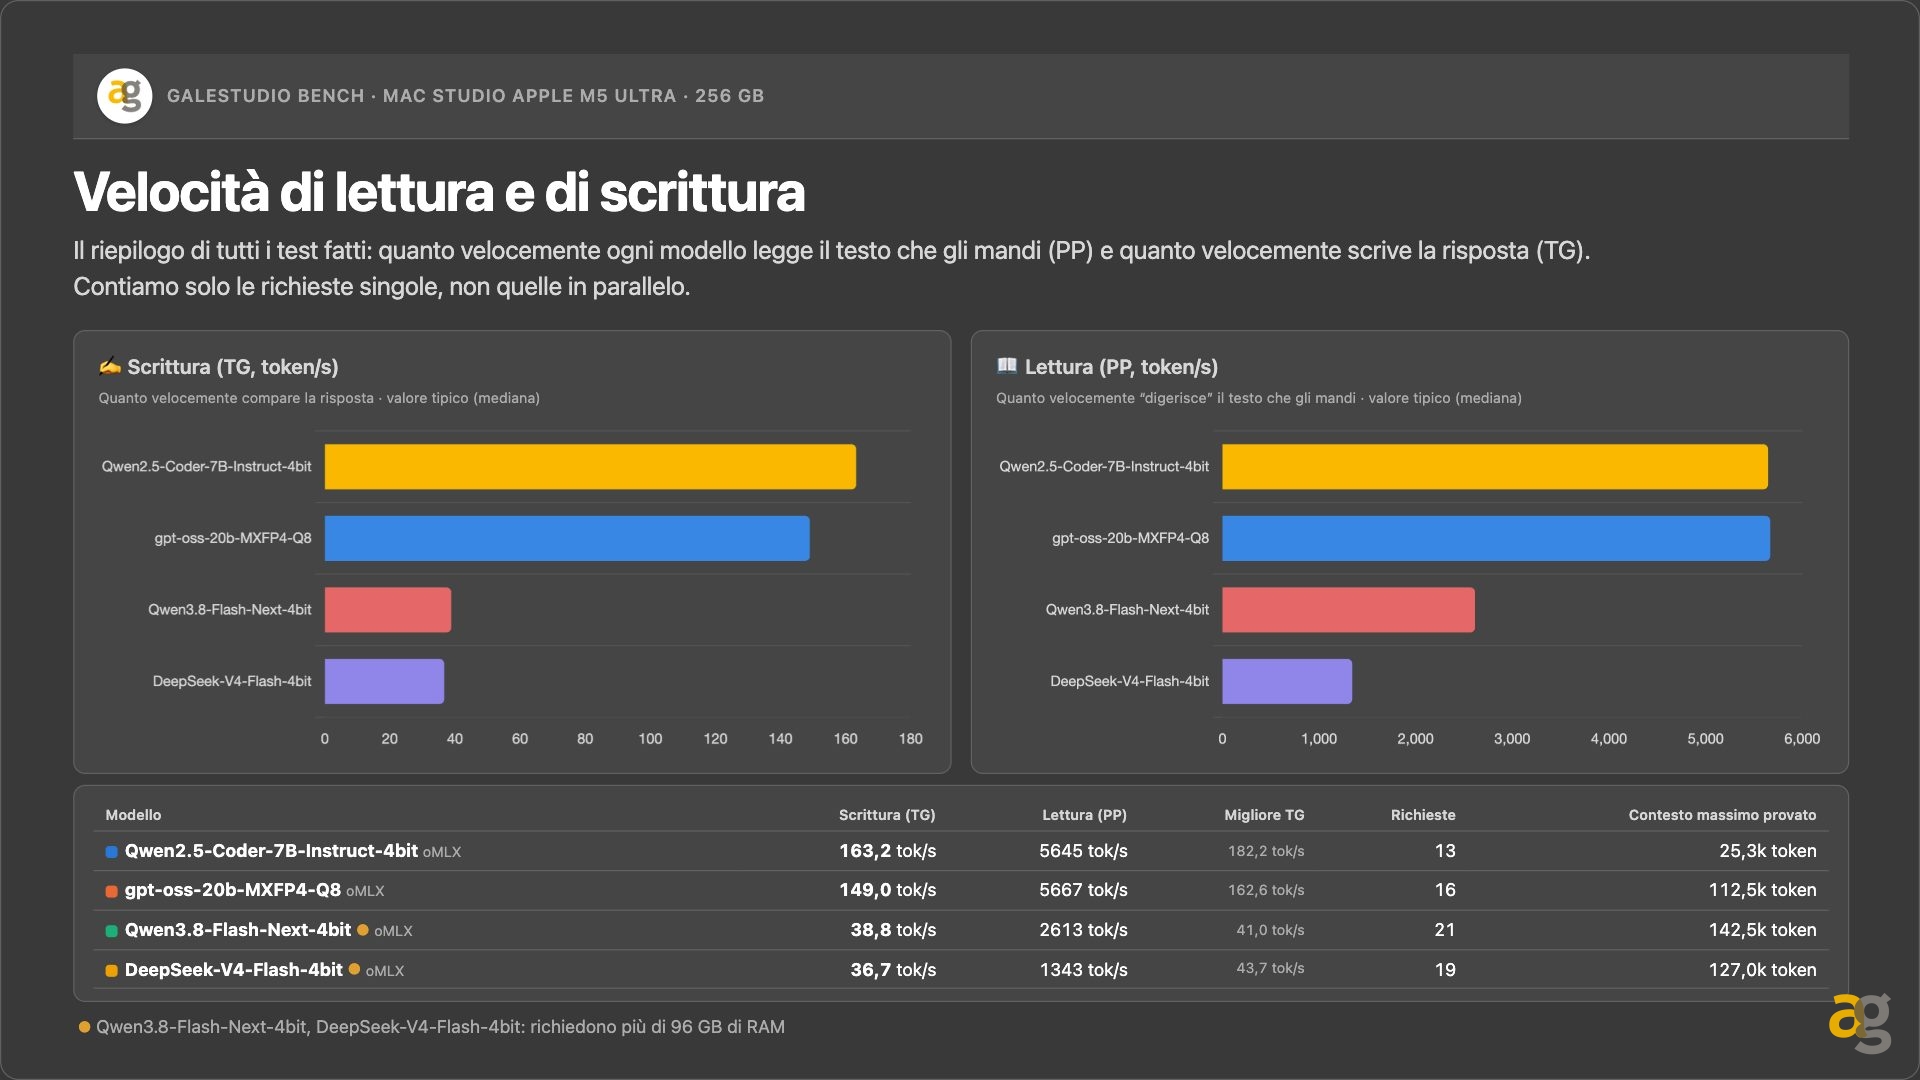
Il primo risultato è abbastanza intuitivo. Nella generazione vera e propria, cioè mentre vediamo comparire la risposta sullo schermo, l’M5 Ultra passa da circa 68 a 163 token al secondo. È un incremento di circa 2,4 volte.
Già questo è un salto notevole, ma il dato più interessante arriva dal prefill, cioè dalla fase in cui il modello deve leggere ed elaborare il prompt e tutto il contesto che gli forniamo.
Qui si passa da circa 566 token al secondo sull’M2 Max a 5.645 token al secondo sull’M5 Ultra: praticamente dieci volte tanto.
🔍 Clicca sull’immagine per vederla a piena risoluzione
Larghezza di banda: il salto rispetto a M3 Ultra
Uno degli upgrade più importanti dell’M5 Ultra è la larghezza di banda della memoria, cioè la quantità di dati che può passare ogni secondo tra memoria e processori.
M3 Ultra superava gli 800 GB/s. M5 Ultra arriva a circa 1.200 GB/s, quindi 1,2 TB al second e abbiamo quindi un incremento teorico del 50%.
Non significa che tutte le applicazioni vadano automaticamente il 50% più forte. Dipende da quanto il singolo carico sia limitato dalla memoria. Negli LLM, però, questa velocità conta moltissimo, soprattutto nella generazione, perché per produrre ogni nuovo token il sistema deve leggere continuamente i pesi del modello.
Apple ha quindi fatto un lavoro importante sulla banda. Adesso, però, deve continuare a crescere anche nella capacità di calcolo della GPU. Avere una quantità enorme di memoria serve fino a un certo punto se poi il processore non riesce a utilizzare un modello gigantesco a una velocità accettabile.
È anche per questo che l’assenza di una configurazione da 1 TB non ci sembra oggi un problema reale. Caricare un modello da 900 GB e vederlo procedere a una velocità inutilizzabile non sarebbe un grande vantaggio. La memoria e il compute devono crescere insieme.
Come si misurano le prestazioni di un LLM
Quando si parla di velocità dei modelli linguistici si usano i token al secondo. Un token non coincide necessariamente con una parola: può essere una parola intera, una sua parte, un segno di punteggiatura o un gruppo di caratteri. La suddivisione cambia in base al modello e alla lingua.
Nei benchmark bisogna distinguere due valori che spesso vengono confusi.
Il primo è il prompt processing, chiamato anche prefill. Indica quanto velocemente la macchina legge ed elabora ciò che le forniamo: il prompt, la conversazione precedente, un documento oppure migliaia di righe di codice. È particolarmente importante quando si lavora con contesti lunghi.
Il secondo è la text generation e misura quanti token vengono prodotti durante la risposta. È il dato che percepiamo più facilmente perché determina quanto velocemente le parole compaiono sullo schermo.
Una macchina può essere eccezionale nel prefill e molto meno distante nella generazione. Per questo non basta dire che un computer fa un certo numero di token al secondo: bisogna sempre capire di quali token stiamo parlando.
Il benchmark fatto con llama.cpp
Per essere più omogenei possibili anche con dei test pubblici, abbbiamo usato i test di llama.cpp, pubblicati su Github qui: https://github.com/ggml-org/llama.cpp/discussions/4167
Abbiamo ottenuto questi risultati:
| Macchina | Prompt processing | Text generation |
| Mac Studio M2 Max | circa 671 token/s | circa 66 token/s |
| Mac Studio M3 Ultra | circa 1.471 token/s | circa 92 token/s |
| Mac Studio M5 Ultra | circa 4.595 token/s | circa 160 token/s |
Il salto più sorprendente è nel prompt processing. In alcuni test reali con Qwen e GPT-OSS l’M5 Ultra ha raggiunto valori tra 9 e 10 volte superiori al nostro M2 Max. È una differenza enorme quando il modello deve leggere molto codice oppure un contesto particolarmente lungo.
Nella generazione il vantaggio rimane evidente, ma è meno estremo. Siamo passati da circa 66-68 token al secondo a valori tra 150 e 163, quindi all’incirca 2,3-2,4 volte.
Per un programmatore questa distinzione è importantissima. Se l’assistente deve leggere continuamente repository molto grandi, il prefill conta tantissimo. Se invece deve produrre risposte lunghe o molto codice, la velocità di generazione diventa più percepibile nell’uso quotidiano.
DGX Spark: una alternativa ma solo per AI locale
DGX Spark è una soluzione professionale che costa oggi circa 4.800 euro sul marketplace europeo NVIDIA, quando è disponibile, e offre 128 GB di memoria unificata.
Nel compute generale e soprattutto nella generazione dei token, M5 Ultra può essere più veloce. DGX Spark, però, ha una capacità di prefill comparabile in determinati carichi. Per chi deve fornire continuamente grandi quantità di codice o documenti al modello, questo dato cambia parecchio la valutazione.
A circa 5.000 euro, con 128 GB di memoria e tutto l’ecosistema software NVIDIA, DGX Spark è quindi un’alternativa ma è però una macchina specializzata. Il Mac Studio rimane anche un computer eccellente per programmare, compilare, montare video, lavorare con la grafica e avviare più simulatori contemporaneamente.
Nel caso di Francesco questo aspetto pesa parecchio. Il Mac può essere usato come nodo AI quando serve e, nel resto della giornata, come workstation principale per lo sviluppo. DGX Spark svolge meglio il ruolo di appliance dedicata, ma difficilmente sostituisce allo stesso modo il computer sulla scrivania.
Più Mac Studio insieme: cosa cambia davvero con Thunderbolt 5
Una delle novità più interessanti, e forse meno raccontate, è la possibilità di collegare più Mac Studio tramite Thunderbolt 5 e trasformarli in un vero cluster per l’intelligenza artificiale. Non si tratta semplicemente di metterli sulla stessa rete: a partire da macOS 26.2 Apple supporta RDMA su Thunderbolt 5, cioè il trasferimento diretto dei dati dalla memoria di un Mac a quella dell’altro, evitando buona parte del lavoro normalmente richiesto alla CPU e al sistema operativo.
Ci sono quindi due vantaggi: il primo è far entrare un modello più grande, distribuendone i pesi tra più Mac. Il secondo è accelerare un modello già eseguibile, dividendo i calcoli. I due obiettivi richiedono strategie diverse e non sempre si ottengono contemporaneamente.
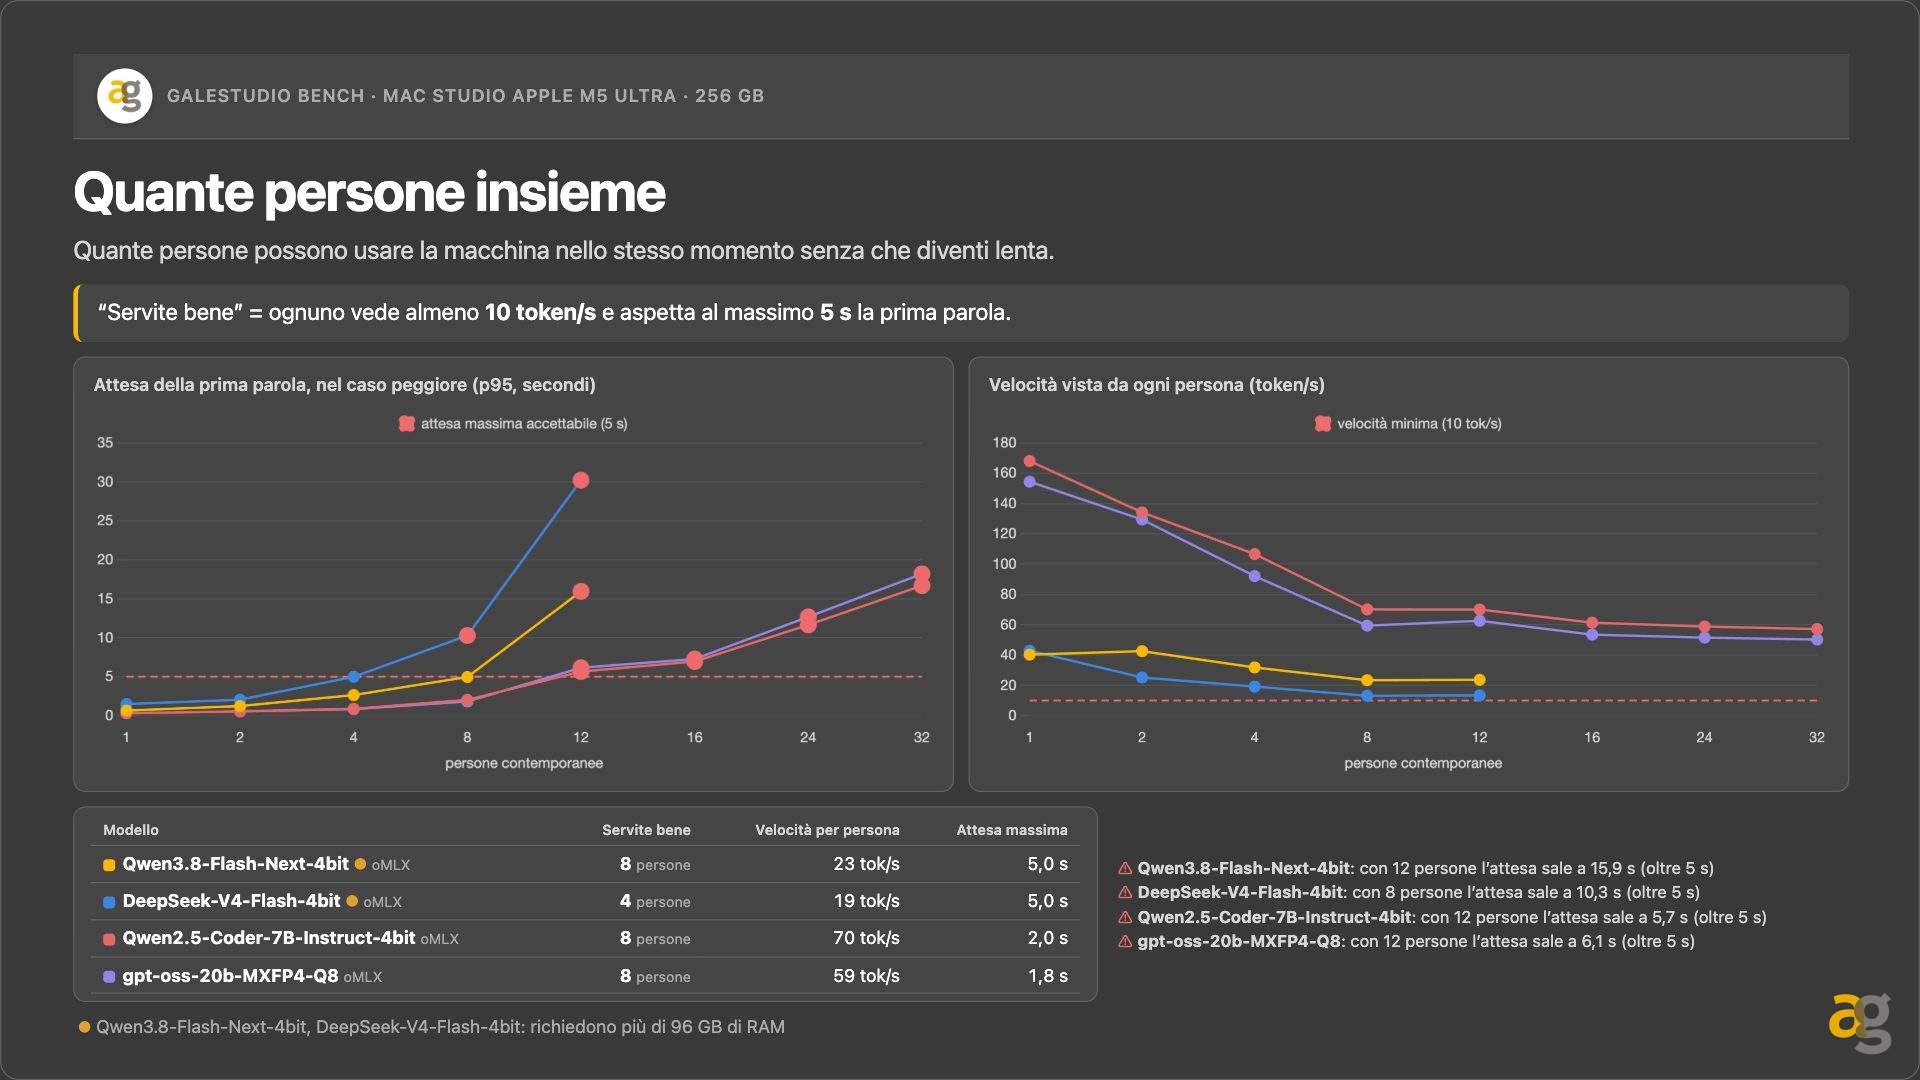
Per una piccola azienda questa è una prospettiva interessante: si può partire da un Mac Studio e aggiungere altri nodi quando crescono modelli e utenti. Ma non è un’espansione plug-and-play paragonabile all’aggiunta di RAM. Prima di acquistare quattro o cinque macchine bisogna provare il modello reale, progettare la rete Thunderbolt e capire se il problema sia la capacità di memoria, il prefill, la generazione o il numero di richieste contemporanee.
DGX Station e il vero salto enterprise
Salendo ancora di livello si arriva al DGX Station (https://www.nvidia.com/en-us/products/workstations/dgx-station-for-windows/), una macchina che dovrebbe collocarsi indicativamente tra 100.000 e 150.000 euro, anche se prezzo e configurazioni definitive andranno verificati al momento della disponibilità.
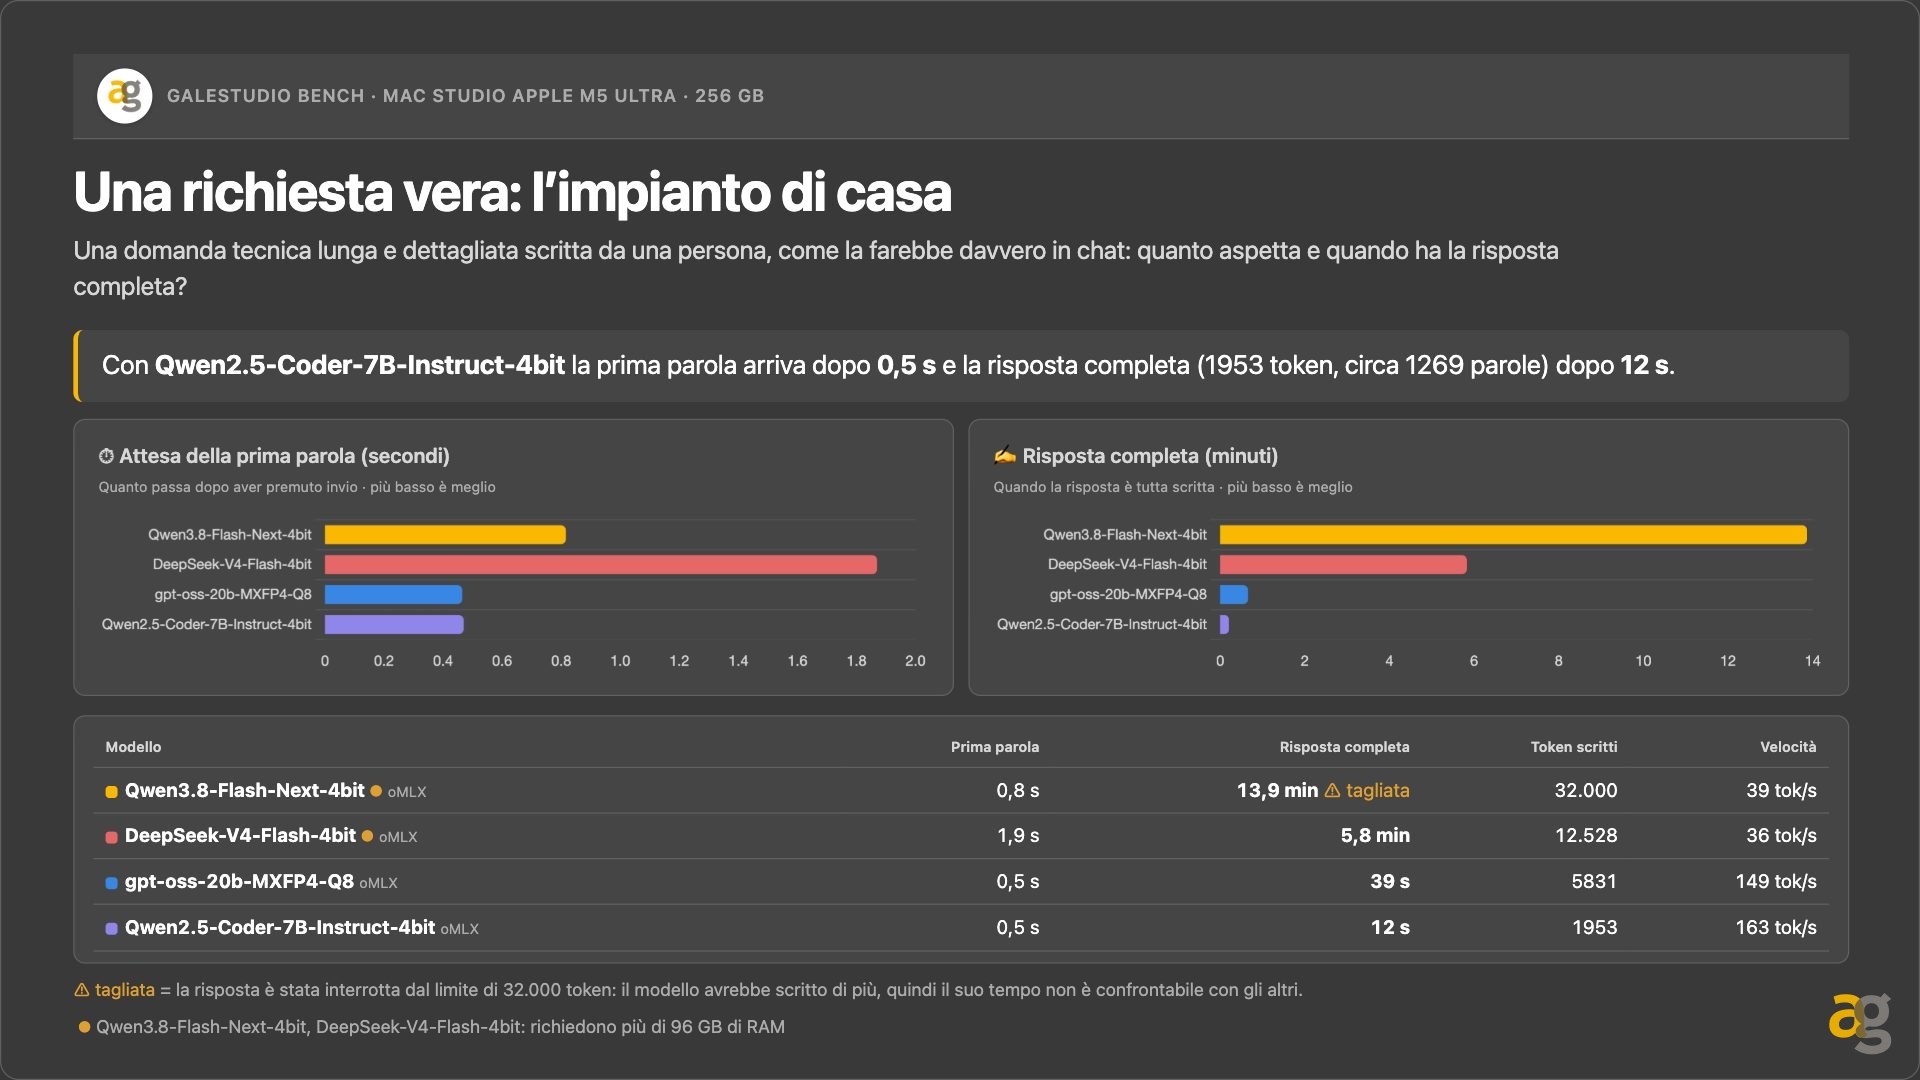
Una DGX Station potrebbe servire 10, 15 o 20 utenti contemporaneamente molto meglio di una singola macchina desktop. Comprare quattro o cinque Mac Studio può portare a una quantità di memoria complessiva simile e a un investimento paragonabile, ma non garantisce la stessa potenza, la stessa interconnessione o la stessa capacità di gestire richieste concorrenti.
Qui cambiano completamente scala e destinatario. Non stiamo più scegliendo il computer di un programmatore, ma progettando una piccola infrastruttura AI aziendale. Prima di spendere 100.000 euro bisogna conoscere con precisione modelli, carichi, numero di utenti e livello di servizio richiesto.
A chi serve davvero
Il Mac Studio M5 Ultra non è per tutti e probabilmente non vuole esserlo.
Ha senso per sviluppatori, studi professionali e piccole o medie aziende che vogliono eseguire modelli in locale senza rinunciare a una vera workstation. È interessante per chi lavora con dati sensibili, non vuole dipendere sempre dal cloud oppure ha bisogno di molta memoria anche per compilazione, video, grafica e simulatori.
Ha molto meno senso per chi utilizza soltanto applicazioni da ufficio, sviluppo leggero o modelli piccoli e ben quantizzati. In quei casi un Mac mini M4 Pro, un Mac Studio meno spinto o perfino una soluzione cloud utilizzata soltanto quando serve possono risultare molto più razionali.
Anche i 256 GB non sono automaticamente la configurazione giusta. Per molti professionisti i 96 GB rappresentano già un punto di equilibrio eccellente. I 256 diventano sensati quando esiste un carico reale che li utilizza, non soltanto il desiderio di avere la configurazione più potente.
🔍 Clicca sull’immagine per vederla a piena risoluzione
Giudizio finale
Tirando le somme, il Mac Studio M5 Ultra è una macchina impressionante. Non soltanto perché è veloce, ma perché combina potenza, una quantità enorme di memoria, consumi bassi e una silenziosità che una workstation tradizionale difficilmente riesce a replicare.
Il prezzo rimane altissimo e gli upgrade Apple fanno lievitare il conto molto rapidamente. La configurazione da 256 GB e 8 TB che abbiamo provato è estrema e non è quella che consiglieremmo automaticamente. La base da 96 GB può essere molto più sensata, soprattutto se prima si scelgono con attenzione i modelli da utilizzare.
DGX Spark è forse l’alternativa più interessante per chi vuole una macchina dedicata esclusivamente all’AI e preferisce l’ecosistema NVIDIA. Mac Studio, invece, vince quando oltre all’intelligenza artificiale serve un computer completo su cui lavorare ogni giorno.
IN PREORDINE ANCHE SU AMAZON QUI IN VERSIONE 96GB
È proprio questa la fascia a cui sembra rivolgersi Apple: programmatori, creator, studi e aziende che vogliono portare una parte dell’AI in locale e hanno bisogno anche di una workstation vera.
La domanda finale quindi non è “qual è la macchina più potente?”. La domanda corretta è “quale macchina utilizzerò davvero?”. Se serve soltanto AI, DGX Spark merita grande attenzione. Se servono AI, sviluppo, simulatori, produttività e un computer destinato a rimanere sulla scrivania per molti anni, Mac Studio M5 Ultra ha molto più senso di quanto il prezzo iniziale lasci pensare.
E in futuro? L’ottimizzazione tornerà a essere fondamentale
Per anni ci siamo abituati ad avere memoria abbondante e relativamente economica. Oggi l’intelligenza artificiale sta facendo esplodere la domanda e il costo di RAM e VRAM torna a essere un problema serio.
Una parte della soluzione sarà continuare ad aumentare la capacità hardware. L’altra, forse ancora più importante, sarà ottimizzare meglio i modelli.
Apple sta lavorando da anni sull’esecuzione on-device e su modelli compatti, progettati per un hardware preciso e per compiti ben delimitati. Le funzioni di Apple Intelligence e Siri non devono necessariamente competere con i modelli generalisti più grandi: devono rispondere bene e rapidamente alle attività per cui sono state progettate, ricorrendo al cloud soltanto quando serve più potenza.
È un ritorno a un modo di sviluppare che sembrava quasi dimenticato. Quando i computer avevano pochi megabyte di RAM, ogni programma doveva essere limato e ottimizzato. Oggi abbiamo modelli da centinaia di gigabyte e stiamo riscoprendo che la forza bruta non può essere l’unica risposta.
Forse il prossimo grande salto dell’intelligenza artificiale non arriverà da modelli ancora più grandi, ma da modelli capaci di ottenere gli stessi risultati con una frazione delle risorse.